用业务语言提问,继续追问口径、原因、趋势和改进动作。
SYSTEM ENGINE · AI DATA ANALYSIS
用自然语言,
读懂真实业务数据
业务人员直接询问客户、合同、跟进、售后或设备数据。吾码先校验当前身份与数据权限,再检索相关 Schema、生成并执行只读查询,最后把数据整理成结论、指标、异常和改进建议。
ASKSCHEMASQLINSIGHT权限先于分析OsClient · DiyToken · Role Policy · Read Only
分析请求发生时才读取当前租户数据库,不把业务明细预复制到向量库。
候选表、SQL 校验和执行结果都受当前用户、角色与租户边界约束。
三个真实移动端预览
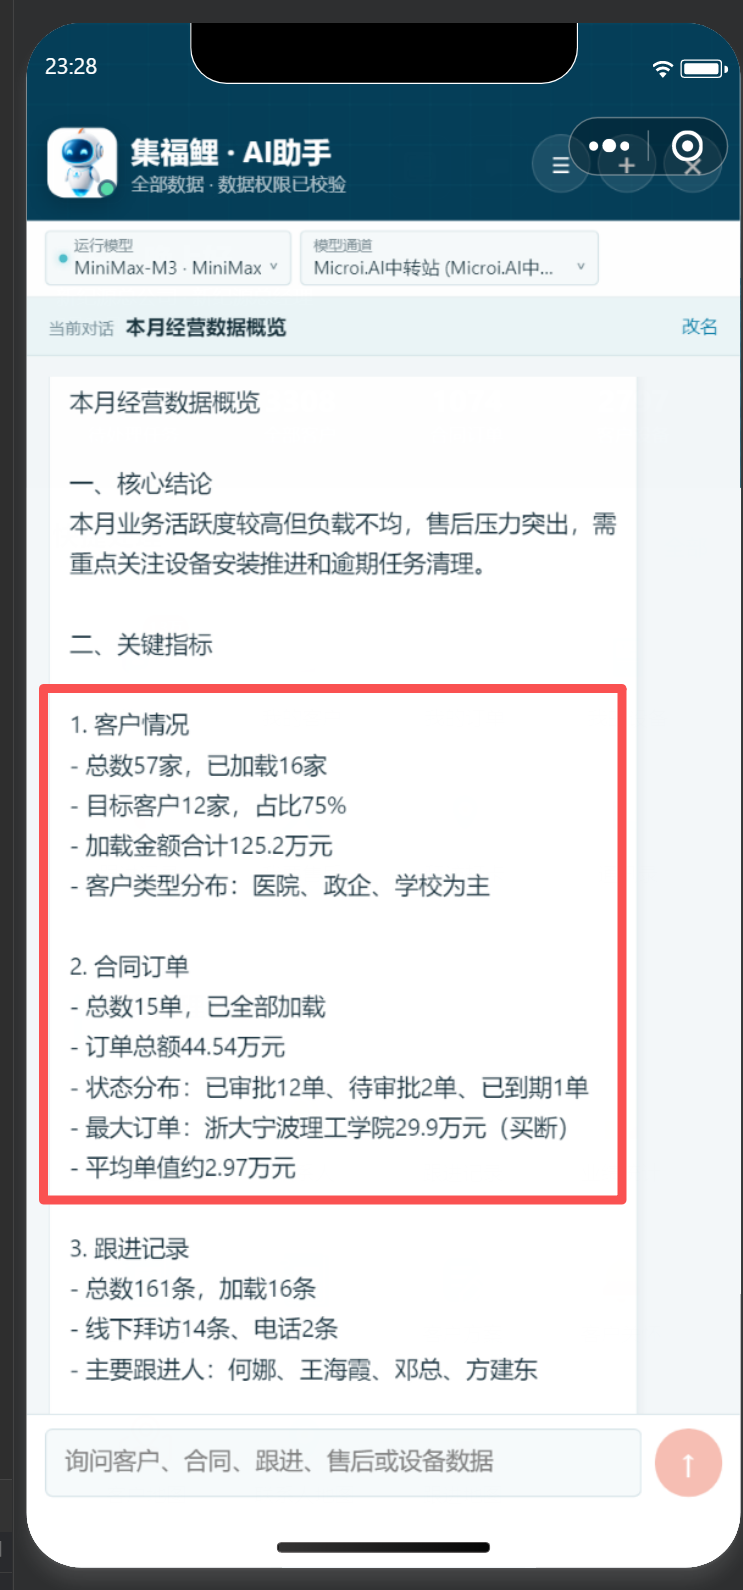
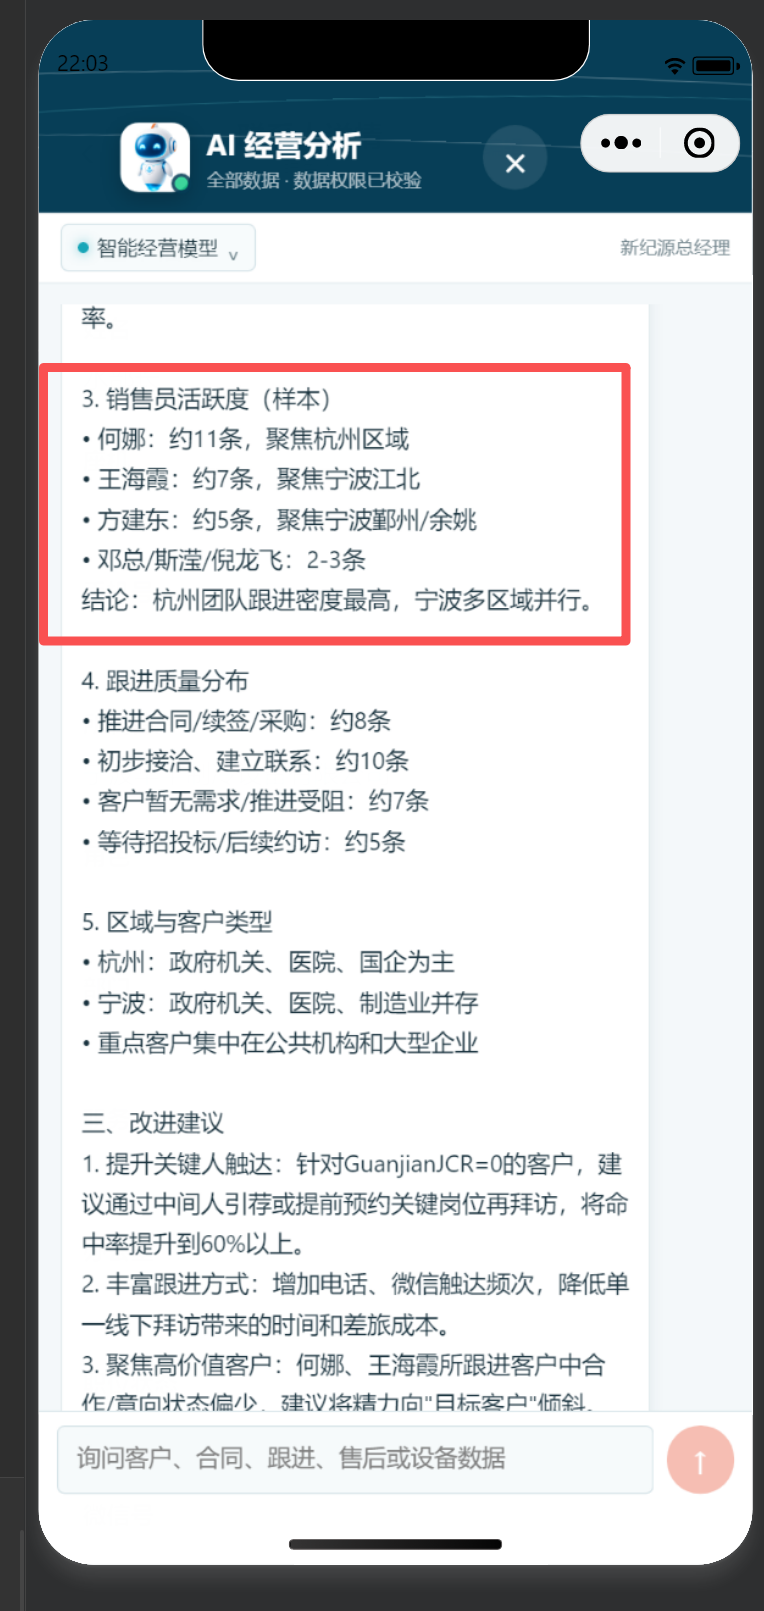
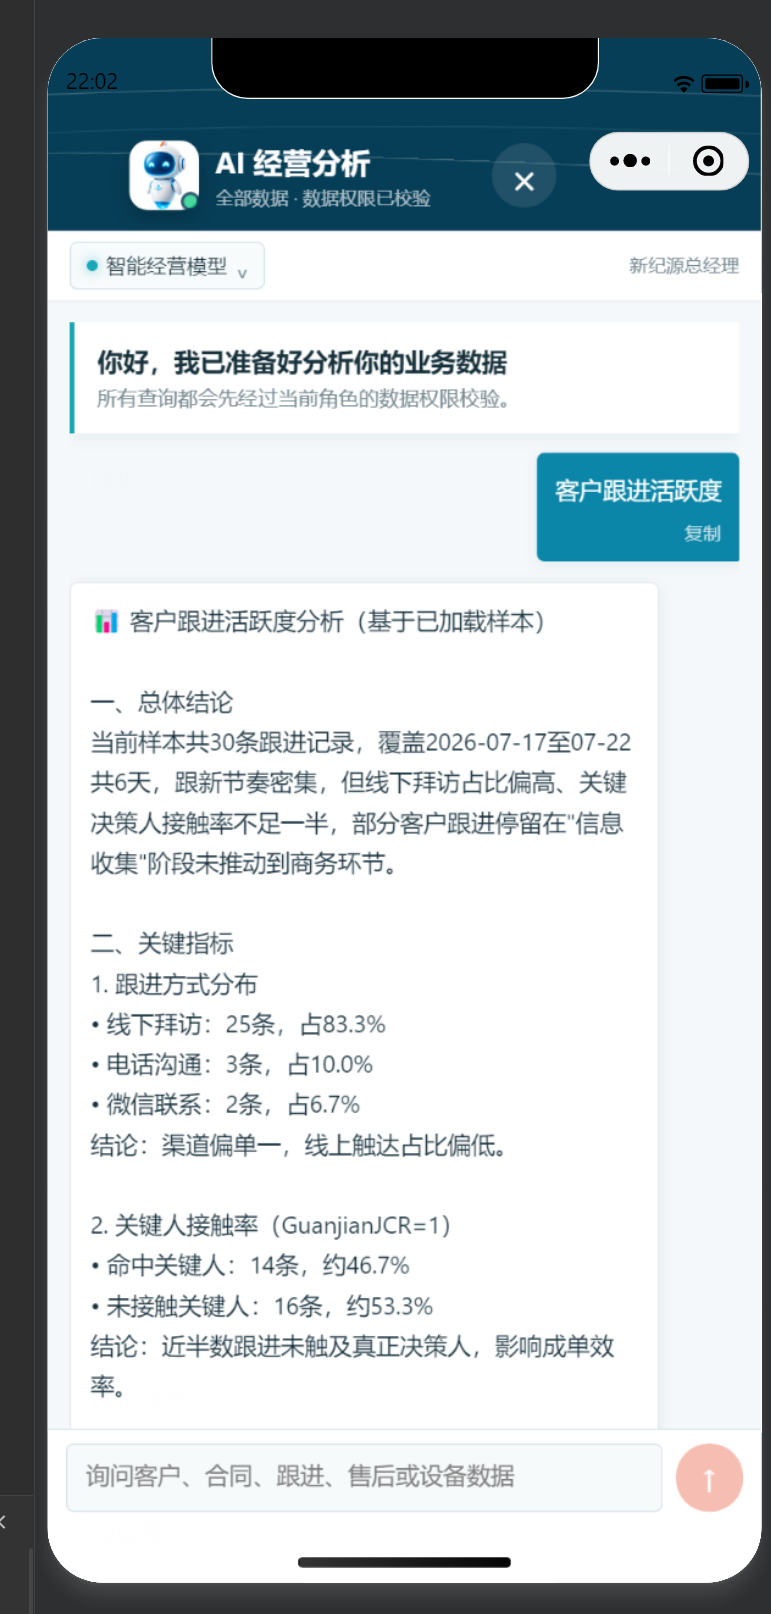
下面三张为实际业务中的原始截图,依次展示经营概览、销售活跃度与客户跟进分析。桌面端每行固定三列,可点击任意图片查看原图;窄屏自动改为单列,避免压缩文字。
原图说明
三张图片均按上传文件的原始字节发布,没有裁剪、重绘或二次压缩。截图用于展示产品能力;其中的业务名称与数据不作为通用培训口径。
它能分析什么
经营概览
客户总量、目标客户、合同订单、金额、售后与设备等跨模块指标。
客户与销售
区域分布、客户类型、销售活跃度、关键人触达与跟进阶段。
执行质量
延期任务、异常状态、长时间未跟进记录与渠道结构偏差。
行动建议
基于已查询事实给出优先级、关注对象和下一步核查方向。
可以从一句宽泛问题开始,再逐步缩小范围:
- “总结本月经营数据,先给三条核心结论。”
- “哪些客户已经有合同,但近 30 天没有跟进?”
- “比较各区域销售人员的跟进活跃度,并解释口径。”
- “找出即将到期的售后任务,只返回我有权查看的数据。”
默认结果以自然语言回答、经过校验的 SQL 与最多 100 行数据表格为主。若需要固定经营看板或图表,应把稳定指标继续交给报表引擎或界面引擎配置;不能把一次对话结果误当成已经发布的正式报表。
从一个问题到可靠结论
绑定身份
从服务端登录态确认 OsClient、当前用户、角色和权限,拒绝客户端覆盖。
理解问题
识别业务实体、时间范围、指标口径和需要继续澄清的条件。
检索 Schema
只在有权访问的表字段中做关键词检索,并从低代码元数据精确回读。
生成与校验
生成单条只读 SELECT,检查来源表、危险语法、行数上限和执行超时。
实时执行
在当前租户数据库查询最新业务数据,结构索引本身不保存业务行。
解释与追问
输出结论、指标、异常和建议,并允许围绕同一上下文继续下钻。
权限、安全与可信边界
| 边界 | 平台行为 | 培训时要强调 |
|---|---|---|
| 租户隔离 | 服务端绑定当前 OsClient,Schema、缓存与数据库按租户隔离 | 页面传参不能切换到其它租户 |
| 表权限 | 候选表必须同时通过 AI 角色策略与 FormEngine 读取权限 | 未授权表不会进入提示词或查询 |
| 行级范围 | 通用 NL2SQL 不尝试猜测复杂菜单 SqlWhere / SqlJoin | 需要部门、本人等范围时改用审核后的业务接口 |
| SQL 门禁 | 只允许单条只读 SELECT,拒绝写操作、多语句和危险来源 | AI 生成不等于直接执行,必须先过服务端校验 |
| 数据规模 | 服务端限制最大行数和数据库命令超时 | 大范围分析应先聚合,再按条件下钻 |
| 输出事实 | 回答来自本次查询结果;模型推断应与已查询事实分开表达 | 关键经营决策仍需核对原始数据与口径 |
数据不会先被“喂给”向量数据库
默认链路使用大模型关键词扩展、权限感知 Schema 搜索和精确字段回读。Redis 与可选 Qdrant 只保存表字段等结构信息,订单、客户、金额等业务行仍在每次请求时从当前租户数据库实时查询。
独立培训建议
一节 35~45 分钟的 AI 数据分析培训可按下面顺序现场完成:
- 用“本月经营概览”演示从宽问题到核心结论。
- 展开 SQL 与数据表,核对来源表、时间范围和指标口径。
- 继续追问销售活跃度或客户跟进质量,观察上下文承接。
- 切换不同角色,验证未授权表和数据范围不能被问题绕过。
- 将一个稳定指标交给报表或界面引擎,说明对话分析与正式看板的边界。
更完整的模型路由、Schema 缓存、NL2SQL 安全校验和部署参数,继续查阅 AI 引擎与 Microi.AI 中转站。