🛰️ 系统日志/监控
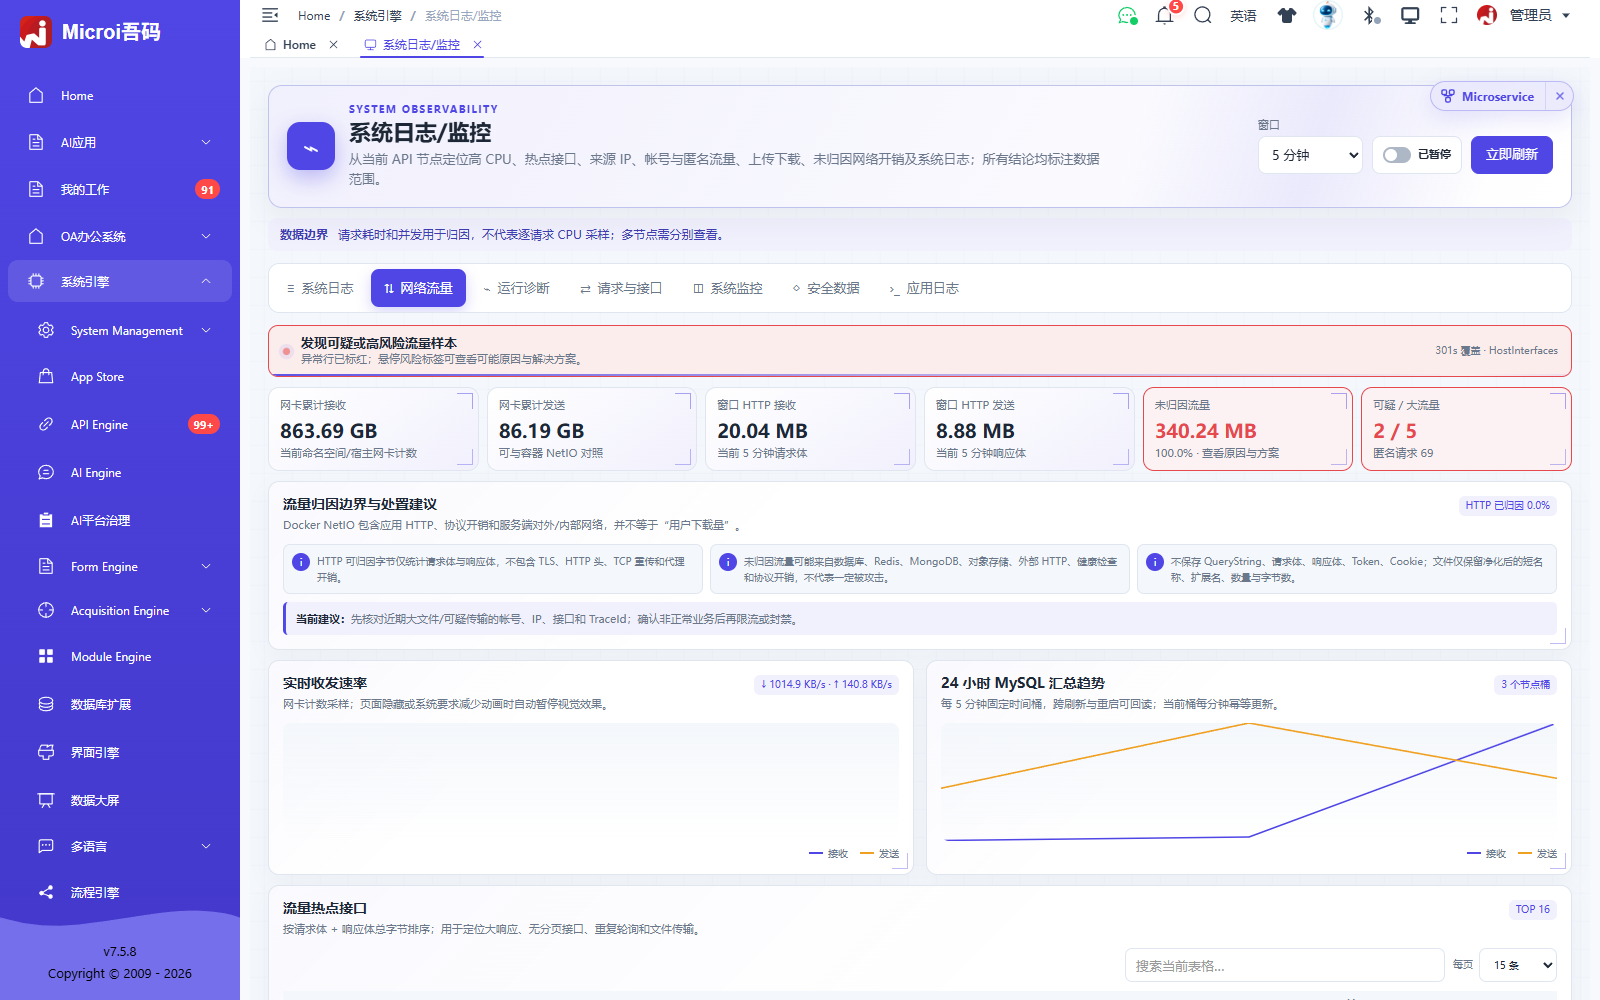
【系统日志/监控】把原系统日志、系统监控和安全日志菜单收口为一个可安装、可升级、可由 AI 查询的可观测性控制台。它用于回答三个最重要的问题:系统现在是否健康、资源消耗来自哪里、异常流量由谁通过什么接口产生。
功能亮点
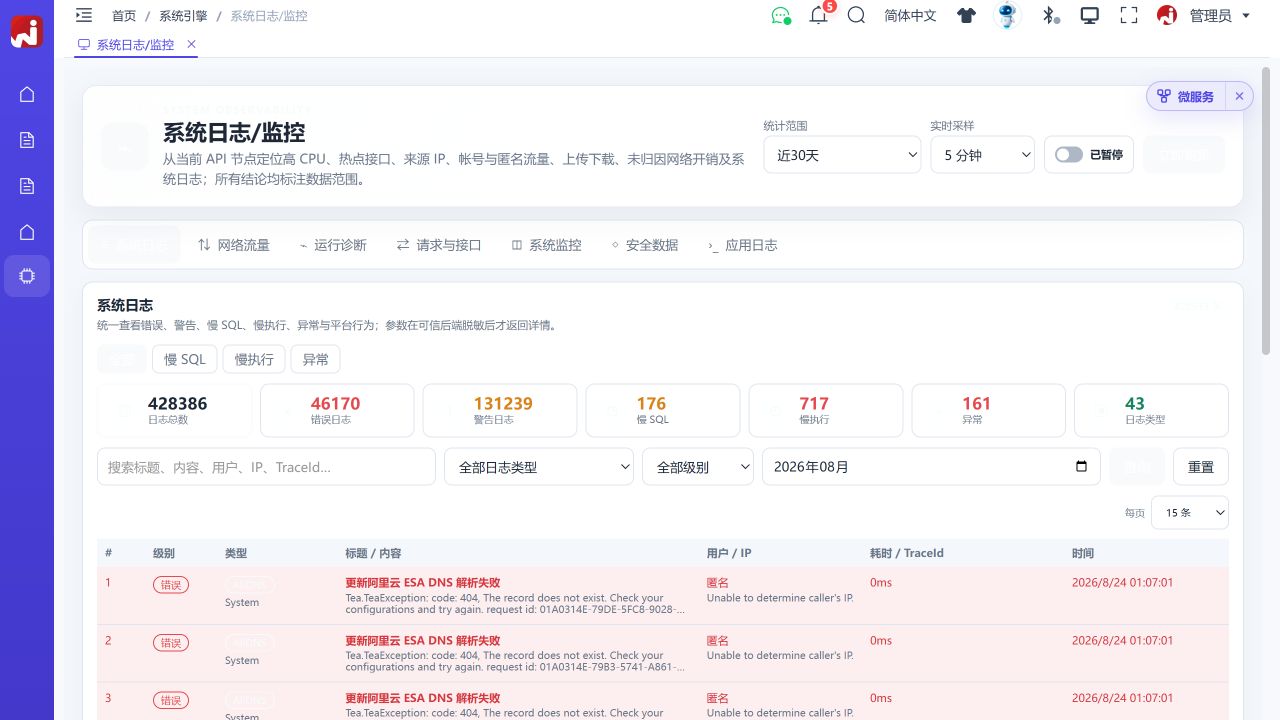
- 日志仍是第一入口:首个 Tab 提供日志总数、错误、警告、慢 SQL、慢执行、异常统计,支持组合筛选、搜索、每页 15 条默认分页和完整详情。
- 从现象追到根因:热点接口按窗口总耗时贡献排序,同时展示请求数、平均/P95、异常率、活动请求与 W3C TraceId 时间线。
- 网络流量可归因:同时展示网卡/容器累计与窗口增量、HTTP 请求体/响应体字节、未归因残差,并按接口、IP、帐号/匿名、租户和内容类型排名。
- 高价值异常留证:普通高频样本只留短窗口内存;错误、慢请求、大文件和可疑传输通过有界队列异步写 MongoDB;长期趋势写入 MySQL 固定时间桶。
- 运行态一屏诊断:覆盖进程 CPU/内存/线程/GC、主机、磁盘、网卡、Docker 容器、日志队列、正在执行与最近完成请求。
- 安全数据与治理:统一查看安全访问、攻击事件、活动封禁,并在核对代理/NAT 后封禁或解封 IP;所有动作复核权限并写审计。
- 主题化驾驶舱:界面跟随平台主题,异常标红并给出原因/方案;持续动效仅使用低成本属性,在页面隐藏或“减少动态效果”时自动暂停。
- AI 原生:MCP 提供统一只读查询和有确认门的 IP 治理工具;能力目录、参数上限、权限与真实数据边界均可机器读取。
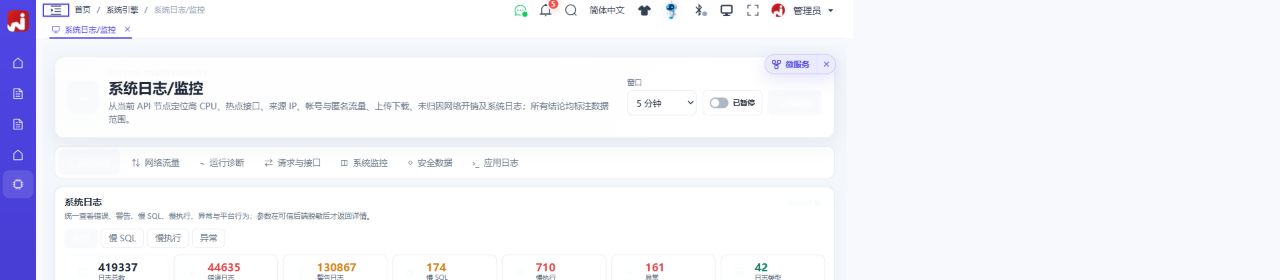
八个功能页
| Tab | 主要能力 | 典型问题 |
|---|---|---|
| 系统日志 | 统计卡、类型/级别/月/关键字筛选、详情、Trace | 为什么报错、哪条 SQL 慢、参数和堆栈是什么 |
| 网络流量 | 收发总量、HTTP 归因、残差、趋势、五类 TOP、大文件/可疑样本 | 30GB 接收和 9GB 发送是什么、谁发的、发给谁 |
| 运行诊断 | 请求率、并发、错误率、P95、热点接口/IP、自动建议 | CPU 高时最值得先查什么 |
| 请求与接口 | 正在执行、最近完成、TraceId、状态与耗时 | 是否有长请求或并发堆积 |
| 系统监控 | 进程、主机、磁盘、网卡、Docker、队列 | 是 CPU、GC、内存、磁盘还是容器问题 |
| 内存与事故 | 执行分配、代码哈希、对象类型/调用栈、跨节点事故历史 | 哪个接口或 V8 事件在异常分配,进程退出前在执行什么 |
| 安全数据 | 访问、攻击、IP 封锁与解封 | 是否被扫描/攻击、是否需要处置某个 IP |
| 应用日志 | 当前 API 进程环形日志尾部、搜索和脱敏 | 服务端最近输出了什么 |
内存吃满与异常退出定位
“内存与事故”使用独立于 V8 资源限制的诊断采集。V8Limit=0/false 继续允许复杂业务执行,采集器不会终止脚本,也不会替业务设置内存或语句限额。仅打开前端页面、升级微服务或开启 V8 限制,都不能代替升级包含诊断运行时的 API。
执行开始时记录租户、接口 Key、表名、事件名、执行/父执行 Id、W3C TraceId 和脚本 SHA-256;不保存脚本正文和业务参数。HTTP、接口引擎内部调用、表单 V8、工作流节点、Job 和 MQTT 的执行入口均可产生身份。尚未返回的执行也进入周期检查点,不再只依赖 finally 中的完成日志。数据筛选事件的身份由实际执行入口决定,不能把浏览器前端 V8 的内存当成服务器内存。
| 证据 | 能回答什么 | 不能据此断言什么 |
|---|---|---|
| 执行独占/含子调用累计分配 | 哪个执行链产生大量托管对象 | 分配量不等于存活量或该接口独占 RSS,父子不能相加 |
| 独立 EventPipe 分配样本与 CLR 栈 | 对象类型、分配方法及关联的接口/V8 事件和代码版本 | 采样不是完整堆;CLR 栈不保证给出 JavaScript 行号 |
| API RSS、托管堆、分配率、GC、宿主余量、cgroup | 托管分配、整体宿主压力、容器上限、OOM kill 计数的区别 | API 只占宿主一部分不代表宿主安全;拿不到的指标显示不可用 |
| MongoDB 驻留内存、WiredTiger 缓存、日志库存储 | Mongo 进程 RAM、缓存和磁盘空间分别多大 | 日志库 22 GB 磁盘占用不等于 Mongo 进程用了 22 GB 内存 |
| 事故检查点和重启恢复 | 重启前尚在运行的执行、最后压力与分配栈 | “未正常退出”不能单独证明 OOM;需结合 cgroup/内核退出证据 |
默认每 2 秒保留一次检查点,实时压力窗口约 2 分钟。宿主余量不足、cgroup 达到 80%、RSS 快速增长、高分配率、OOM kill 计数变化或磁盘空间不足会产生诊断事故;这些阈值仅触发留证,不拒绝业务。独立采集器每段最长采集 15 秒,主体达到 16 MiB 时提前收尾,单段硬上限为 64 MiB;保留最近两段,加上正在写入的一段最多 192 MiB。EventPipe 缓冲固定为 64 MiB,解析工作在受限子进程执行,故障会退避重试并在页面显示降级。
完整 API 的收尾元数据实测约 35 MiB,原 16/32 MiB 缓冲出现丢事件,64 MiB 缓冲的对应验证未丢事件。微软说明 rundown 是恢复动态方法栈所需的收尾数据,大应用的文件体积会明显增加,因此不能用小型测试宿主代替完整平台验收;截断、缺栈和丢事件仍须如实展示。EventPipe 采集配置说明
事故先原子写入 API 内容根目录下的 logs/memory-diagnostics,然后异步写入当前租户 MongoDB 日志库的 memory_incidents。共享事故默认保留 14 天;本机历史有 256 MiB 预算,活动采集片段另受固定上限约束。多节点使用全局事故 Id 幂等补传,旧版本不能覆盖新证据。列表最多 50 条,只读摘要;详情按事故 Id 单独读取,执行身份和栈按可信租户过滤。Mongo 不可用时本机仍可留证,恢复后自动补传;另一节点只能看到已经上传的共享历史。
整个容器退出、独立采集器也来不及完成解析时,重启后会在受限子进程中尝试最后两个原始片段。未写完的尾段可能保留接口身份和对象类型,却缺少方法栈;恢复时保留这部分证据,再补充前一完整片段,缺失栈、丢事件和截断状态仍明确显示。Linux 进程身份使用内核启动标识识别 PID 复用,持久卷清理避开仍被 API、采集器或解析器持有的片段。
上线必须核对:API 发布目录包含 diagnostics/Microi.MemoryDiagnostics.dll 和依赖;进程允许本机 .NET 诊断连接;logs 挂载可写持久卷;页面中的采集器心跳新鲜、丢事件/溢出/存储错误可见。容器重建若丢掉本机卷,尚未补传的证据无法恢复。持久卷无法写入、整机断电、启动初期崩溃、极快 OOM 或长时间线程调度阻塞都可能扩大两秒窗口,不能承诺零丢失。
发生问题时先读取 Memory 的采集质量和压力,再打开 MemoryIncidents → MemoryIncident,沿 Key、事件名、代码哈希和 Trace 查当时版本的业务逻辑。如果 RSS 持续上升但分配样本没有相应热点,应考虑长期存活对象、缓存保留、非托管内存或外部数据库进程;这些情况仍需受控堆分析或数据库侧证据,不能把分配榜第一名自动宣布为根因。
{"action":"microi_query_system_observability","params":{"action":"Memory"}}{"action":"microi_query_system_observability","params":{"action":"MemoryIncidents"}}{"action":"microi_query_system_observability","params":{"action":"MemoryIncident","incidentId":"0123456789abcdef0123456789abcdef"}}先检查证据是否完整
Memory 是当前节点视角;MemoryIncidents 合并当前租户的共享历史与本机记录。先核对 NodeId、BootId、BuildVersion 和 UTC 时间,再解释排行。接口返回 Code=1 只表示查询成功,不代表采集器或存储健康。
| 检查位置 | 正常时应看到 | 异常时如何解释 |
|---|---|---|
Collector.Status/Fresh/SampledAtUtc | 正在采集,心跳新鲜 | Fresh=false 或时间陈旧时,不能用空榜证明没有异常分配 |
Collector.Error/LastCaptureError | 没有持续错误 | 检查 API 是否带采集器、诊断通道和子进程启动权限 |
Collector.LostEvents/OverflowSamples/UnattributedEstimatedBytes | 结合窗口检查遗漏与无归属量 | 非零表示归因有缺口;无归属分配不能硬算给某个接口 |
Executions.RegistryOverflowCount | 活动执行登记未溢出 | 发生溢出时,执行列表不是所有活动请求的完整清单 |
Evidence.LocalStorageError/DroppedUnuploadedFiles | 无写盘错误、无未上传记录被预算淘汰 | 磁盘满或卷不可写会损失证据,应优先处理留证条件 |
Evidence.SharedStorageError/PendingUploads | 共享写入正常,积压能够回落 | Mongo 不可用时先读本机;其它节点看不到尚未补传的记录 |
事故 Stacks 与 Evidence.StackQuality | 样本、缺失栈、截断和丢事件均可检查 | 硬退出尾段可能只有对象类型/执行身份;缺栈不等于没有分配 |
事故列表/详情均从 Data.Items 读取。详情的 Items 为空表示在当前租户、节点与共享存储可见范围内没有找到该记录;不是“该时刻系统没有故障”。incidentId 必须来自列表的 Id,不接收文件路径,也不通过参数切换到其它租户。
自动留证的触发条件
下表是当前内置诊断阈值,只触发记录和采样,不中断业务,也不打开 V8 内存保护。这些阈值不是新的接口数据量限制。
| 事故 Trigger | 触发条件 |
|---|---|
HostMemoryPressure | 宿主可用内存低于 2 GiB 与总内存 10% 两者中的较小值 |
ContainerMemoryPressure | 可读取的 cgroup 内存使用达到有效上限的 80% |
RapidRssGrowth | 相较约 10 秒前,API RSS 增长至少 256 MiB |
HighAllocationRate | 托管分配率达到 128 MiB/s |
CgroupOomKillObserved | cgroup 的 OOM kill 计数增加;仍需核对具体被杀进程 |
DiskSpacePressure | 诊断目录所在磁盘可用空间低于 256 MiB |
当前压力窗口最多 60 帧,正常每 2 秒采样。持续事故合并更新,压力消退超过 60 秒或单次记录超过 5 分钟后封存。采集与解析进程另有内存和运行时限,诊断故障会显示降级;不能把这套有界采集当成持续全量性能分析器。
人工与 AI 共用的定位步骤
- 确认采集条件:执行
Capabilities→Memory,记录节点、版本、时间、采集质量、存储错误和主机/cgroup 余量。 - 找事故窗口:查询
MemoryIncidents,以发生时间与Trigger选择Id,再调用MemoryIncident。重启后优先读历史,不能仅看已恢复正常的当前内存。 - 关联真实执行:从执行记录和分配样本读取接口 Key、表与事件、工作流节点、执行/父执行 Id、脚本哈希和 TraceId。父调用的含子调用分配不能与子调用重复相加。
- 核对当时源码:通过 MCP 获取对应接口引擎或 V8 事件源码及版本记录。当前源码哈希不同于事故记录时,先找事故发生时版本,不能拿今天的代码冒充当时执行内容。
- 检查分配路径:沿对象类型与 CLR 栈,结合
Trace、慢 SQL、请求字节、循环、逐行查询、大对象序列化和缓存写入,建立可验证的原因假设。浏览器 V8 事件要追到其调用的后端 API。 - 验证保留和压力来源:若 RSS 持续增长而分配热点不匹配,继续查存活对象、缓存、非托管内存,以及 Mongo/MySQL 等独立进程。采样不能代替受控堆分析或数据库执行计划。
- 修复后对照复测:相同业务数据、并发和窗口下比较返回结果、分配率、托管堆、RSS、GC、P95/P99 与错误率。先验证业务正确,再判断是否消除了异常增长。
最终诊断应分别列出“已证实的事实、最可能原因、缺失证据、修复与复测结果”。证据完整时有较高机会缩小到具体接口或事件;准确定位长期存活对象或某一行 JavaScript,仍取决于事故类型与补充分析。定位概率属于条件性的工程判断,不能用一次演练结果推导通用成功率或承诺 100%。
MCP 与后端版本不匹配时
| 现象 | 含义与处理 |
|---|---|
MCP 的 describe_tool 没有三个 Memory 动作,或参数报 invalid_enum_value | 当前进程加载的是旧 MCP。更新 @microi.net/cli/吾码插件与工作区 AI 配置;已运行会话继续工作,新版本在后续新进程生效 |
| 专用工具支持 Memory,但返回“不支持的系统观测动作” | 核对目标 API 二进制及 mci-system-observability-query 引擎;不能用开启 V8Limit 解决版本缺失 |
| 返回“当前后端未安装内存诊断运行时” | API 没有注册诊断运行时;仅更新 MCP 或前端微服务无法补足 |
Collector 持续不可用 | 检查发布目录中的 diagnostics 依赖、诊断通道和子进程;页面可用不等于分配采集可用 |
| Mongo 异常但本机记录可读 | 按本机证据继续分析,并修复共享补传;保留卷恢复前不要清理原始片段 |
优先使用专用 MCP 工具。旧进程缺少新动作、而标准 microi_run_engine 仍可调用时,可临时只读执行固定引擎 mci-system-observability-query,参数使用 Action=Memory/MemoryIncidents/MemoryIncident 和列表返回的 IncidentId。这仍受同一租户和后端权限校验;禁止为绕过限制创建临时维护引擎、执行任意 SQL、修改 Token 或取消权限验证。
后端框架、商城微服务与查询引擎、MCP/CLI、文档/Skills 是独立交付项。验收要分别记录版本与真实回读;“源码已修改”“npm 已发布”“页面已更新”均不能代替目标服务器采集心跳和事故查询验收。
两项性能数据如何理解
选项查询的 1,001 行,不是通用查询上限
“物化”指数据库返回的一行被转换成 .NET 对象,并放入内存集合。这次修复只覆盖字段 SQL 选项查询:该入口原本最多向选项控件返回 1,000 项,却先把整个结果集转成对象,再截取前 1,000 项。
现在只物化最多 1,001 行:前 1,000 行仍作为选项返回,第 1,001 行只判断结果是否超限、是否需要提示“数据过长”。SQL 排序与前 1,000 项的返回语义保持一致。
| 调用 | 本次是否新增 1,001 行上限 |
|---|---|
字段 SQL 选项查询 GetDiyFieldSqlData / GetFieldsData 中的选项加载 | 是,只限制此处的对象物化;实际选项仍最多 1,000 项 |
V8.Db.FromSql(sql).ToArray() / .ToList() | 否,按原 SQL 和执行方法工作 |
V8.FormEngine.GetTableData('xxx', {}) | 否,仍按原有查询、分页、权限和既有约束工作 |
例如以下通用业务查询没有被这项修复改成“最多 1,001 条”:
// FromSql 构造查询,ToArray 才执行并生成结果。
var rows = V8.Db.FromSql('select * from xxxx').ToArray();
// 不新增 1,001 行限制;空条件不是建议的生产批量读取方式。
var result = V8.FormEngine.GetTableData('xxx', {});这不是对任意 SQL 自动追加 LIMIT 1001。数据库仍可能扫描、排序或计算很多行;本次验证的是客户端对象物化和分配减少,不代表 SQL 扫描量、传输量或数据库 CPU 按同样比例下降。大量选项仍应使用搜索、分页、合适索引和精简字段。
隔离 MySQL 测试使用 20,000 行测试数据:托管分配从 49,203,016 字节(约 49.2 MB)降至 2,490,952 字节(约 2.49 MB),减少约 94.9%;排序与连接复用验证通过。20,000 行是测试规模,不表示每次线上事故都读取了同样行数,也不表示整台服务器内存下降 94.9%。
纯 JavaScript 循环约 22% 开销与优化
下面的 22% 是早期逐语句诊断实现的历史测量,不是优化后实现的固定成本。 2026-09-08 的源码优化已移除诊断专用的 Jint Constraint,改用执行边界记录和后台身份刷新;目标服务器需要部署配套的后端与采集器后才会生效。
一次隔离微基准执行 200,000 次累加循环,两组都预热 3 次,再交替测量 10 轮。对照组只运行 Jint;观测组增加执行诊断检查,两组均未开启 V8 业务资源限制。
| 指标 | 结果 |
|---|---|
| 对照耗时中位数 | 24.2282 ms |
| 增加观测后的耗时中位数 | 29.4760 ms |
| 单次差值 | 5.2478 ms |
相对耗时增加 (29.4760 / 24.2282 - 1) × 100% | 21.66%,约 22% |
原因是解释器在语句执行路径增加诊断检查:每次检查有方法调用、计数和分支成本;每累计 2,048 次检查再读时钟,到约 200 ms 间隔时更新执行观测心跳。虽然不是每条语句都完整采样,检查入口本身仍有成本,纯计算循环会突出这项开销。
这个结果表示该循环用时增加约 5.25 ms。 它不是服务器 CPU 使用率增加 22 个百分点,不是内存增加 22%,也不是所有 HTTP 接口一律变慢 22%。数据库、网络和 I/O 的时间占比因业务而异,真实端到端开销必须测量。
该测试不包含独立 EventPipe 采集/解析、完整 HTTP 链路与生产并发,不能当作整套监控的总成本或上限。诊断检查用于给长循环留执行身份和分配线索,不设置终止条件;不能把它解释为默认打开了 V8 内存保护。
优化后哪些工作同步,哪些在后台
- 执行边界同步记录:进入、退出、异常、异步上下文切换时,记录当前执行身份并结算当前线程的累计分配。这些操作不逐条写 MongoDB,不在每条 JS 语句前检查。
- 后台刷新身份:单个独立后台线程约每 200 ms 刷新业务线程身份,避免业务线程池耗尽时定时回调也停摆;事件携带原始操作系统线程 Id 和递增版本。采集器中途启动或会话轮换后可重新关联长循环,过期身份不会覆盖较新的调用或复活已结束调用。身份注册表有 10,000 条上限。
- 独立采样与存储:对象分配和方法栈继续由独立 EventPipe 采集器获取;本机检查点和 MongoDB 补传继续在后台执行。
后台刷新身份不代表业务取得进展,也不能跨线程读取“当前线程累计分配量”。 长循环尚未经过下一个执行边界时,上方执行累计值可以暂时滞后,应结合对象类型分配样本查看实时变化。采样值、已结算累计值和存活内存不能互相替代;未归属样本和事件丢失继续显式报告。
最终微基准仍使用 200,000 次累加,各预热 10 次、平衡执行顺序测量 60 轮。优化组使用同一个平台引擎实例交替启用/省略诊断作用域,计入身份进入、退出和分配结算成本,以排除不同实例布局差异;平台引擎与裸 Jint 的绝对时间不直接比较。
| 优化后同配置对比 | 关闭执行诊断的中位数 | 启用边界记录与后台刷新 | 中位数差值 |
|---|---|---|---|
| Windows 本地测试 | 24.6168 ms | 24.3032 ms | −0.3136 ms,约 −1.27%,属于测量波动,不能据此宣称加速 |
| Linux 容器,2 CPU / 2 GiB 上限 | 28.7750 ms | 28.8427 ms | +0.0677 ms,约 +0.24% |
这次有限样本中,Windows P95 为 31.1117 → 30.1709 ms,Linux P95 为 34.3232 → 35.4739 ms。调度与 GC 波动仍存在,不能承诺线上固定低于某个百分比或宣称零开销。两组均关闭 V8 业务资源限制,性能微基准不包含 EventPipe 与生产 HTTP;EventPipe 的正确性另以 Windows/Linux 两租户持续执行、延后接入、会话轮换、线程池耗尽与离线栈解析测试验证。
MCP 的 Memory 动作保持不变。排查优化版时可补查 Executions.ObservationMode、IdentityRegistryOverflowCount、NativeThreadIdentityUnavailableCount、IdentityRefreshFailureCount,以及 Collector.BackgroundIdentityRefreshes、ObservedIdentityProtocolVersion、RejectedStaleIdentityMarkers。缺少这些字段可能是旧版后端,不能自动按零故障解释。
本次内存诊断完善覆盖哪些问题
| 完善项 | 对事故定位的作用 |
|---|---|
| HTTP Trace 统一为 W3C 标识,日志、流量和执行链共用 | 避免把服务器请求流水号当成 TraceId,导致关联查询断裂 |
| 活动请求总数与展示样本上限分开,明确截断状态 | 高并发时仍能判断真实堆积量,不把只展示的少量请求当成全部 |
| HTTP、接口引擎嵌套调用、表单/工作流事件、Job、MQTT 执行身份 | 关联具体资源、父子执行、代码版本与 Trace |
| 长循环心跳、异步执行归属与运行中检查点 | 尚未返回或来不及执行完成日志时仍有定位线索 |
| 独立分配采样、对象类型与 CLR 栈 | 从“某接口内存高”继续追到实际分配路径 |
| 持久记录、Mongo 幂等补传、跨节点历史和租户过滤 | 共享存储短暂故障或进程重启后继续查询事故 |
| Linux 进程启动身份、采集租约、最后两个片段恢复 | 处理 PID 复用、容器改名/强杀与未完成尾段;保留缺栈状态 |
| 有界队列/记录/原始片段和轻量摘要查询 | 约束监控自身的内存、磁盘与查询成本 |
| 字段选项读取时提前停止物化 | 修复已验证的过量对象分配,同时保留业务选项语义 |
这些功能帮助定位和验证根因,不替代业务修复。上线后至少演练一次“长执行中退出 → 重启 → 查询事故详情”,同时核对正确租户、代码身份、采集质量和持久卷;生产环境不应直接通过制造真实 OOM 来验收。
系统日志
系统日志默认显示 15 条,可切换 30、50、100 或 200 条。搜索和筛选在服务端执行,不会只过滤当前页。统计区域保留:
| 指标 | 含义 |
|---|---|
| 日志总数 | 当前月份与筛选条件下的总数 |
| 错误日志 | Level 为错误的日志 |
| 警告日志 | 风险、降级或需要关注但未必失败的日志 |
| 慢 SQL | 数据库执行时间超过阈值的 SQL 日志 |
| 慢执行 | 接口、V8、任务或外部依赖执行过慢 |
| 异常 | Exception、运行时异常或平台保护事件 |
点击任意行会打开平台级弹窗,遮罩整个系统框架。详情可包含日志级别、类型、耗时、用户、IP、Api、AppId、请求方法、客户端、节点、环境、TraceId、标题、内容、参数、其它信息、可执行 SQL 与 Trace 时间线。敏感键值在可信后端递归脱敏后才返回。
标题与副标题最多显示两行;完整内容通过详情查看。错误、长耗时和可疑流量会标红,悬停可查看常见原因与处置建议,例如:
- 慢 SQL:检查执行计划、索引、分页、返回字段、排序/Join 与锁等待。
- 慢执行:检查外部接口、逐行 I/O、大对象序列化、线程池与接口引擎循环。
- 异常:沿 Trace 时间线先处理第一个根因,避免调用方无界重试。
- 大流量:检查无分页响应、轮询、下载/上传、压缩、Range、CDN 与对象存储直传。
CPU 与热点接口怎么解释
热点接口的“耗时占比”表示它在选定窗口内贡献的请求总耗时比例,适合排序定位。例如某接口占 36%,说明先检查它最划算,但这不等于该接口精确消耗了 36% CPU。数据库等待、外部 HTTP、锁等待和序列化都会拉高请求耗时。
“进程 CPU(多核原始)”允许超过 100%。例如 247.7% 表示进程当时约使用 2.477 个逻辑核,并不等于整台服务器已经使用 247.7%;判断节点是否过载应优先看按逻辑处理器数归一化后的进程 CPU,再结合主机 CPU、请求率、活动请求、GC 和 P95。控制台把归一化 CPU 作为主指标,同时保留原始值和等效核心数用于容量分析。
排查顺序:
- 记录当前节点、窗口、进程 CPU/内存、业务请求率、活动请求、P95 与错误率。
- 查看热点接口和来源 IP,区分“少量超慢”与“高频中等耗时”。
- 打开正在执行/最近完成请求,复制 TraceId。
- 在系统日志详情和 Trace 时间线定位首个慢步骤、SQL、外部调用或异常。
- 对同一接口以相同负载复测;同时看 P50/P95/P99、RPS、错误率、CPU、内存和分配率。
需要规范压测时参阅项目内 microi.skills/performance-testing/SKILL.md。
热点榜时间范围
右上角“5 分钟”表示实时诊断采样窗口,不是系统只保存 5 分钟。全局时间范围支持:实时 5 分钟、今天、昨天、近 3 天、近 7 天、近 15 天、近 30 天、近 3 个月、近 6 个月和近 1 年。选择历史范围后,热点接口、流量趋势、来源 IP、帐号、租户和内容类型使用同一时间边界,避免不同卡片口径不一致。
| 查询跨度 | 汇总粒度 | 默认保留 | 用途 |
|---|---|---|---|
| 实时窗口 | 内存分钟桶 | 当前进程有界窗口 | 找正在发生的慢请求、并发和流量突增 |
| 约 48 小时内 | MySQL 5 分钟桶 | 48 小时 | 今天、昨天和近 3 天的细粒度回放 |
| 约 45 天内 | MySQL 小时桶 | 45 天 | 7/15/30 天趋势和接口排行 |
| 更长历史 | MySQL 天桶 | 400 天 | 3/6 个月和 1 年容量趋势 |
历史查询只扫描有索引的固定时间桶,并对相同租户、范围和 TOP 参数做短 TTL Redis 缓存;5 分钟汇总完成后会同步重建小时/天桶并自然失效缓存。MongoDB 只保存受限的高价值明细,不承担跨月排行榜的全表扫描。功能启用前已经过去的流量不会凭空回填,部署后会从第一个完整汇总桶开始积累。
后台任务大响应治理
POST /api/BackgroundTask/List 是后台任务中心的列表接口,默认每页 15 条、最大 100 条,只返回标题、状态、进度、时间和 HasLog/HasResult 等摘要;不再把 Log、Result、参数、可信用户快照和检查点随每一行重复返回。用户展开某一任务时才按任务所有权调用详情接口,轮询进度只调用轻量状态接口。旧客户端显式请求超大页也会被服务端限制,因此不能再通过页面参数制造数 MB 的任务列表响应。
网络流量:知道“谁、从哪来、通过什么、传了多少”
网络驾驶舱分三层展示数据,避免把容器 NetIO 误解为用户下载量:
| 层次 | 能回答什么 | 不能回答什么 |
|---|---|---|
| 网卡/容器累计与窗口增量 | API 节点或容器总体收发规模与速率 | 不能直接归属到某个用户或 HTTP 接口 |
| HTTP 可归因字节 | 接口、IP、帐号/匿名、租户、内容类型的请求体/响应体字节 | 不包含 TLS/HTTP 头、重传和非 HTTP 通信 |
| 未归因残差 | 提醒还有数据库、Redis、Mongo、MQ、对象存储、外部 HTTP 或协议开销需要查 | 不能强行算给某个帐号、IP 或接口 |
五类流量排名
- Endpoint:定位大响应、无分页接口、重复轮询、上传/下载路由。
- IP:定位高频来源和可疑外部地址;封禁前确认可信代理和 NAT。
- User:授权完成后按帐号聚合,未携带有效身份统一标记“匿名”。
- Tenant:共享 API 节点按请求租户聚合。
- ContentType:识别 JSON 大响应、二进制下载、表单上传等资源类型。
系统只对大文件、错误、慢请求或可疑传输保留有界明细,包括清洗后的接口、IP、帐号/匿名、租户、内容类型、收发字节、状态、耗时和 TraceId;不保存文件内容、请求正文或响应正文。
发现异常后的建议
| 现象 | 常见原因 | 优先措施 |
|---|---|---|
| 单接口响应字节很大 | 无分页、字段过多、重复数据、文件走 API | 分页/选择字段、压缩、对象存储直传、Range/CDN |
| 匿名上传或可疑样本 | 接口匿名开放、鉴权失效、扫描攻击 | 核对业务、关闭匿名、限流、文件类型/大小校验、必要时封禁 |
| HTTP 很低但容器 NetIO 很高 | DB/Redis/Mongo/MQ/对象存储/外部 HTTP | 对照连接与依赖指标、反向代理和对象存储日志 |
| 同一 IP 高频小请求 | 轮询、爬虫、攻击、错误重试 | 缓存/SignalR、退避、速率限制、核对后封禁 |
| 4xx/5xx 大响应 | 错误页/堆栈过大、调用方反复失败 | 缩小错误响应、按 Trace 修根因、限制重试 |
存储与性能架构
HTTP 热路径
  ├─ 原子计数 + 有界分钟桶(内存,当前节点)
  ├─ TOP N 维度聚合(接口/IP/帐号/租户/内容类型)
  └─ 仅高价值样本 → 有界日志队列 → MongoDB 批量写入

后台汇总
  ├─ 5 分钟固定桶 + 确定性幂等键 → MySQL 批量 upsert
  ├─ 小时桶(45 天)/ 天桶(400 天)→ 幂等重建
└─ 热点查询 → 租户隔离 Redis 短缓存设计约束:
- 请求线程不逐条同步写 MySQL/MongoDB,也不序列化完整请求或响应。
- 队列、维度基数、明细大小和保留时间都有硬上限;故障时走 spool/WAL,不创建无界内存队列。
- 历史趋势直接读取 MySQL 汇总,不能每次扫描 MongoDB 明细重新统计。
- Redis 只用于短期热点结果、限流或租约;Key 必须包含租户和查询摘要,写入后主动失效,并保留短 TTL。
- 非重要高频日志适合 MongoDB;长期统计、治理记录和可索引汇总适合 MySQL。
权限、隐私与作用域
- 系统观测敏感数据和 IP 治理只允许平台可观测性管理员,通常要求
Level >= 9999,最终以服务端权威判定为准。 - 不记录 QueryString、Cookie、Authorization、Token、密码、Secret、API Key、请求正文或响应正文。
- 文件只记录经过清洗且有长度上限的名称/扩展名/数量/字节。
Snapshot、活动请求、应用日志、进程和 Docker 数据是当前节点视角;多节点需要逐节点采集或接入统一遥测平台。- Windows 宿主机网卡计数可能包含同机其它进程;Linux 容器网络命名空间更接近容器边界,但仍包含全部协议和依赖通信。
AI / MCP 调用
连接 Microi MCP 后,先发现能力:
{
  "action": "microi_query_system_observability",
  "params": { "action": "Capabilities" }
}查询最近 24 小时接口流量:
{
  "action": "microi_query_system_observability",
  "params": {
    "action": "TrafficHistory",
    "dimensionType": "Endpoint",
    "hours": 24,
    "pageIndex": 1,
    "pageSize": 15
  }
}查询统一历史驾驶舱(支持 today/yesterday/3d/7d/15d/30d/3m/6m/1y):
{
  "action": "microi_query_system_observability",
  "params": {
    "action": "HistoricalDashboard",
    "range": "30d",
    "top": 10
  }
}分页定位近 7 天的上传、大文件和可疑传输(MongoDB 只保存脱敏元数据,不保存正文或文件内容):
{
  "action": "microi_query_system_observability",
  "params": {
    "action": "TrafficDetails",
    "rangeKey": "7d",
    "transferAction": "Upload",
    "pageIndex": 1,
    "pageSize": 15
  }
}查询日志:
{
  "action": "microi_query_system_observability",
  "params": {
    "action": "Logs",
    "keyword": "超时",
    "level": 3,
    "searchMonth": "202608",
    "pageIndex": 1,
    "pageSize": 15
  }
}IP 治理必须两步执行。第一次不传 confirmExecution 只返回 dry-run;核对后再传精确确认值:
{
  "action": "microi_manage_system_observability",
  "params": {
    "action": "BlockIp",
    "ip": "203.0.113.10",
    "blockMinutes": 30,
    "reason": "核对后确认为异常高频访问",
    "confirmExecution": "BlockIp:203.0.113.10"
  }
}完整 AI 决策、存储、权限、扩展和验收规范见 microi.skills/system-observability/SKILL.md。
安装与升级
【系统日志/监控】由框架底层能力和应用商城资源共同组成:
- 先升级 Microi 框架到兼容版本(最低 v7.5.8,推荐当前最新版)。
- 在【应用商城】安装或更新【系统日志/监控】应用。
- 应用包会交付数据表、字段、索引/DDL、Managed 接口引擎、菜单、微服务全部源码和编译产物。
- 刷新登录态后进入菜单,确认八个 Tab、默认 15 条分页、日志详情、网络历史、内存事故与安全数据。
- 通过 MCP 查询
Capabilities和Snapshot,确认 AI 工具、权限和目标租户均正确。
只更新框架不会自动替代租户已安装的商城应用;只更新应用也不能补齐旧后端缺失的可信原子能力。
验收清单
- [ ] 系统日志是第一个 Tab,统计、筛选、搜索、15 条默认分页和详情可用。
- [ ] 详情弹窗遮罩完整平台框架,内容脱敏,标题/副标题最多两行。
- [ ] 错误、长耗时和可疑流量标红,悬停可看到原因与解决方案。
- [ ] 热点接口、活动请求、Trace、进程、主机、Docker、队列、应用日志可回读。
- [ ] 网卡/容器、HTTP 归因和未归因残差分层展示,边界文案真实。
- [ ] Endpoint/IP/User/Tenant/ContentType 排名可按今天、昨天、3/7/15/30 天、3/6 个月和 1 年查询。
- [ ] 5 分钟、小时、天三级 MySQL 汇总可分页查询,重复汇总保持幂等,历史查询不扫描 MongoDB 明细。
- [ ] 后台任务列表默认 15 条且不含日志、结果、参数、可信用户和检查点;详情与状态按需读取。
- [ ] MongoDB 故障不阻塞业务请求,MySQL 固定桶重复汇总保持幂等。
- [ ] V8 限制关闭时仍能采集执行分配;500 个活动请求的真实数量和截断样本分开显示。
- [ ] 独立采集器在线且健康;Mongo 故障、强杀、重启/容器改名后,事故从持久卷恢复并可由另一节点读取,旧重放不覆盖新证据。
- [ ] 分配量/存活量/RSS、Mongo RAM/磁盘空间和未知退出原因都有明确边界,采集丢失或不可用不会显示为健康。
- [ ] MCP 能发现查询/治理工具,Trace 缺参拦截,IP 治理先 dry-run 再精确确认并审计。
- [ ] 主题、深色、移动端、减少动态效果和低配设备渲染均通过检查。
底层 V8 原子方法签名见V8 后端函数:系统日志/监控可信原子。